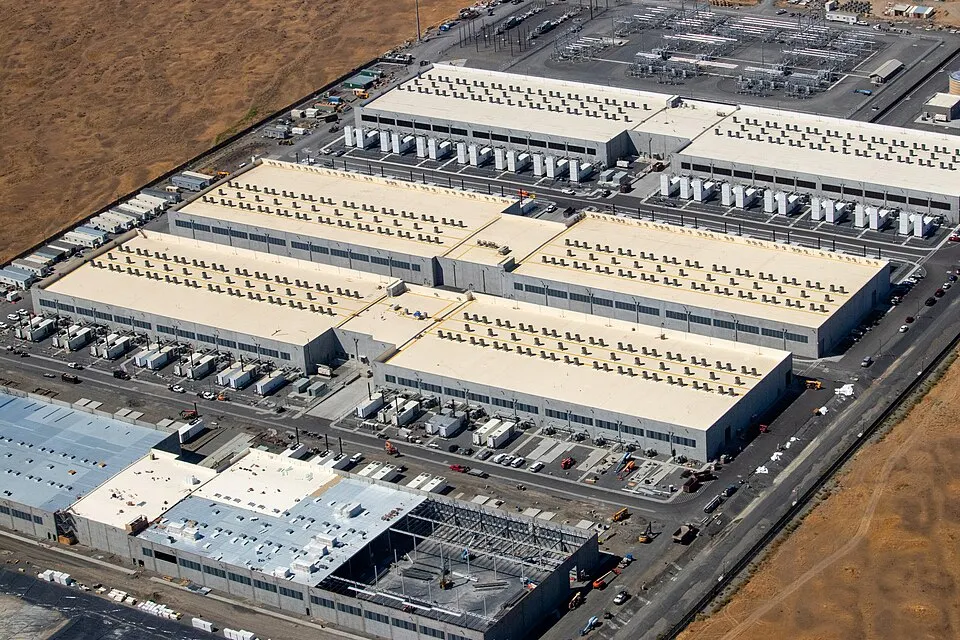
[La campagne des midterms aux Etats-Unis a été marquée par les nombreuses mobilisations contre l’implantation croissante de centres de données et un grand nombre d’exigences de moratoires, entre autres au Texas, le nouveau lieu d’implantation d’Elon Musk. Ces centres de données multiplient l’extraction de ressources (énergie, eau), provoquent des nuisances sonores (souffleries de refroidissement) et dévalorisent le prix de nombreux terrains, ce qui est une forme d’expropriation de petits et moyens propriétaires.
Les investissements massifs des milliardaires détenteurs du système productif sous-jacent à l’IA font donc face à une contestation sociale et politique. Or, cette oligarchie économique est empreinte d’une volonté ultra-autoritaire afin de défendre ses intérêts imposants. S’affirme ici une intrication sociale et politique entre les cercles trumpistes et cette ploutocratie, organisant une tentative d’hégémonie politico-doctrinale. De plus, leur projet conduit à transformer une partie de l’infrastructure matérielle du capitalisme états-unien. Pour l’heure ces investissements fonctionnent comme moteur d’une croissance déformée, avant qu’éclate la bulle de l’IA, conjointement à une crise du private credit et de la dette privée, qui se profile depuis un certain temps. La récente «vague bleue» démocrate va se heurter à cette digue.
L’article que nous publions se centre sur une tentative de comptabilité – en termes de dépense d’énergie, d’extraction de «terres rares» et d’émissions de gaz à effet de serre – du «cycle de vie de la diffusion de l’IA à l’échelle mondiale». – Réd. A l’Encontre]
*****
Par Erald Kolasi et Jesse Damiani
L’essor de l’IA marque un tournant révolutionnaire pour les réseaux énergétiques et les chaînes d’approvisionnement mondiaux. La croissance du secteur de l’IA a été si rapide et si intense que les analystes se bousculent pour publier des prévisions toujours plus stupéfiantes. Une étude du FMI datant de 2025 estimait que la consommation annuelle d’électricité liée à l’IA pourrait atteindre environ 1500 TWh d’ici 2030, soit l’équivalent de la consommation actuelle de l’Inde, un pays comptant 1,4 milliard d’habitants [1]. Le cabinet international de conseil en gestion McKinsey estime quant à lui que ce chiffre pourrait être encore plus élevé, dépassant les 2000 TWh [2]. Cette onde de choc liée à la diffusion mondiale est alimentée par un boom historique et sans précédent des infrastructures: centres de données, centrales électriques, installations de recyclage de l’eau, usines de fabrication de semi-conducteurs (fabs-usine spécialisée où le silicium brut est transformé en circuits intégrés, micropuces), sous-stations électriques, réseaux de transport d’électricité, entrepôts automatisés, et bien d’autres encore (voir illustration en vignette). Les centres de données ont d’abord proliféré avec l’essor du cloud computing dans les années 2000 et 2010, alors que de nombreuses entreprises passaient des entrepôts de données sur site au cloud dans le but de réduire leurs coûts et d’accroître leur efficacité. Mais la vague d’IA de nouvelle génération qui a suivi le lancement de ChatGPT en 2022 a entraîné une incroyable poussée de construction de nouveaux centres de données et la mise en place d’un réseau d’infrastructures connexes. Bien qu’un mouvement d’opposition locale se développe effectivement contre cette expansion de l’IA, les classes dirigeantes mondiales se sont focalisées sur une formule simple: l’énergie d’abord, les questions ensuite. Malgré un débat approfondi sur les impacts énergétiques, environnementaux et matériels de l’essor de l’IA, nous ne disposons toujours pas d’évaluations rigoureuses et objectives qui tiennent compte de la dynamique complexe du cycle de vie de la diffusion de l’IA à l’échelle mondiale.
C’est donc l’objectif principal de cet article: raconter l’histoire de l’IA et de l’énergie à l’échelle mondiale, en élargissant le champ d’analyse bien au-delà de ce qu’aucune autre étude n’a fait auparavant. Les systèmes d’IA tels que Gemini et ChatGPT consomment d’énormes quantités d’électricité, mais le développement de l’univers de l’IA implique les réseaux énergétiques et les chaînes d’approvisionnement à travers le monde. L’essor de l’IA est certes une histoire d’électricité, mais c’est aussi une histoire d’énergie, d’eau, de métaux, de matériaux et de thermodynamique. Il faut produire de l’acier et du ciment pour construire des centres de données. Il faut poser des câbles à fibre optique pour acheminer les données et les informations des centres de données vers les entreprises et les consommateurs. Les puces informatiques doivent être fabriquées à l’aide de certaines des machines les plus avancées que l’humanité ait jamais conçues. Et ces machines sont si délicates et complexes qu’elles doivent être démontées lors de leur expédition, puis remontées avec le plus grand soin sur place. Le géant néerlandais des semi-conducteurs ASML expédie chaque année des centaines de machines de lithographie de pointe. Pour une seule machine à ultraviolets extrêmes (EUV), ASML (Advanced Semiconductor Materials Lithography), a besoin en moyenne de 3 avions-cargos, de 40 conteneurs de fret et de 20 camions pour acheminer les composants démontés vers la Taiwan Semiconductor Manufacturing Company (TSMC) à Taïwan, qui utilise ces machines pour produire les puces les plus avancées au monde [3]. Le réseau électrique taïwanais repose principalement sur le charbon et le gaz naturel, et comme TSMC consomme à elle seule environ 10% de l’électricité de l’île, l’industrie des semi-conducteurs à Taïwan est très émettrice de carbone [4].
***
Ces enjeux nous ont amenés à nous interroger sur les détails et à mener les recherches nécessaires pour répondre à certaines questions décisives. Quelle quantité d’énergie l’humanité consomme-t-elle du fait de l’adoption et de la diffusion généralisées des systèmes d’IA dans l’économie mondiale? Quelle part de la consommation énergétique mondiale en 2026 devrait être attribuée à l’IA? Qu’est-ce qui est considéré comme un système d’IA, au juste? Quelle est la quantité d’émissions mondiales de gaz à effet de serre (GES) générée par l’adoption et la diffusion de l’IA? Comment l’essor de l’IA affecte-t-il les réseaux énergétiques mondiaux et les chaînes d’approvisionnement industrielles? Où va toute cette expansion énergétique, et quels effets pourrait-elle avoir sur la biosphère planétaire au cours de la décennie à venir?
Il s’agit, à notre connaissance, de la première analyse quantitative qui tente de décortiquer l’empreinte énergétique et les émissions mondiales liées à la diffusion de l’IA pour une seule année (2026), ainsi que de fournir les données et le contexte nécessaires à une analyse complète du cycle de vie. Les études sur l’IA et l’énergie sont légion, mais comme nous le verrons bientôt, elles se limitent généralement à diverses pièces d’un puzzle plus vaste sans en assembler l’ensemble. Cet article mettra l’accent sur les impacts de la diffusion de l’IA tout au long de son cycle de vie à l’échelle mondiale. Lorsque les chercheurs calculent l’empreinte hydrique du bœuf, ils ne s’arrêtent pas à l’eau consommée dans le McDonald’s local. Ils prennent en compte l’eau utilisée pour élever la vache, celle nécessaire à la culture des plantes qui la nourrissent, ainsi que d’autres maillons de la chaîne d’approvisionnement, ce qui leur permet de conclure que 98% de l’empreinte hydrique des produits carnés est imputable à l’eau utilisée pour la culture des aliments pour animaux [5]. Ils effectuent des analyses similaires lorsqu’ils souhaitent calculer l’empreinte carbone des centrales à charbon ou des technologies d’énergie renouvelable. Le secteur de l’IA ne devrait pas faire exception, mais trop souvent le discours public et universitaire sur le sujet peut donner l’impression d’être une caricature aléatoire de ce qui se passe réellement.
Cela s’explique par le fait que l’IA est souvent considérée comme un produit plutôt que comme un secteur par de nombreux chercheurs universitaires et par le grand public. Les produits sont localisés dans l’espace et isolés. Le hamburger est juste là, entre vos mains. ChatGPT vous envoie une réponse personnalisée directement sur votre appareil. Lorsque l’on ne voit que des unités isolées et déconnectées, les conséquences qui en découlent paraissent elles aussi, presque par définition, mineures et isolées. Mais lorsque l’on change de perspective et que l’on considère l’IA comme un secteur mondial, on commence à se rendre compte qu’elle comporte des chaînes d’approvisionnement interdépendantes, des économies d’échelle, des effets de réseau, une intégration technologique et une agglomération industrielle. Ce n’est alors plus une entité isolée. C’est une mégamachine mondiale dévorant tout sur son passage. C’est précisément parce que l’IA est en réalité un secteur proposant une large gamme de produits et de services que nous pouvons la soumettre au même type d’analyse du cycle de vie que celui utilisé pour d’autres secteurs.
***
Le secteur de l’IA a une empreinte environnementale énorme qui peut être décrite à travers deux composantes fondamentales: les émissions opérationnelles et les émissions intrinsèques. Les émissions opérationnelles sont les émissions de GES qui résultent directement de l’électricité consommée par les systèmes d’IA pour l’entraînement, l’inférence [quand le modèle d’IA déjà entraîné est utilisé en production pour analyser de nouvelles données et faire des prédictions] ou toute autre opération courante. En revanche, les émissions intrinsèques correspondent à l’ensemble des émissions générées tout au long du cycle de vie, depuis la fabrication, le transport, la construction, l’installation, le recyclage et la mise hors service du matériel physique et des infrastructures qui soutiennent l’écosystème cloud au sens large, y compris des activités telles que la fonte de l’acier, le malaxage du béton, le nettoyage des plaquettes de silicium, et bien d’autres encore. De même, la consommation d’énergie peut également être décrite en termes d’émissions opérationnelles et intrinsèques.
Les entreprises technologiques et les chercheurs favorables aux technologies se sont traditionnellement concentrés sur le carbone opérationnel et la consommation d’énergie, car ils sont faciles à mesurer et encore plus faciles à masquer par le biais de compensations carbone, de crédits et d’autres mécanismes de «greenwashing» qui ne font pratiquement rien pour résoudre les problèmes écologiques fondamentaux résultant du déploiement mondial de l’IA, notamment l’énorme consommation d’eau et les changements radicaux d’utilisation des sols aux implications de grande envergure [6].
Comme le montrera cette analyse, les émissions de carbone opérationnelles et la consommation d’énergie liées à l’utilisation électrique de l’IA ne constituent qu’une pièce importante d’un puzzle bien plus vaste. L’impact réel se situe à la fois en amont et en aval des opérations sur site, depuis l’ensemble des chaînes d’approvisionnement mondiales qui produisent à un rythme effréné le matériel informatique et les infrastructures physiques formant les fondements du déploiement de l’IA, jusqu’aux effets de rebond et aux conséquences en aval sur les ménages, les entreprises et les gouvernements qui utilisent les systèmes d’IA à un rythme sans précédent.
Nous utilisons le terme «onde de choc» pour souligner les niveaux d’investissement colossaux qui alimentent l’expansion et la diffusion des technologies d’IA. Nous ne nous prononçons pas ici sur la question de savoir si ces technologies sont en elles-mêmes impressionnantes ou révolutionnaires. Les technologies peuvent se répandre pour toutes sortes de raisons, parfois parce qu’elles sont véritablement révolutionnaires, et d’autres fois parce qu’elles sont simplement imposées à la société par les classes dirigeantes. Certaines caractéristiques des modèles d’IA sont sans aucun doute impressionnantes et changeront la nature du travail et de la société humaine au sens large, mais parallèlement, ces modèles présentent également des faiblesses fondamentales ou des problèmes potentiels susceptibles de limiter leur diffusion et leur universalité à l’avenir, notamment les hallucinations, les «murs de données» [barrière théorique et technique que rencontrent les modèles d’intelligence artificielle lorsque leur progression est freinée par l’épuisement ou la raréfaction des nouvelles données de haute qualité disponibles pour les entraîner], les barrières d’abstraction [phénomène par lequel les outils deviennent de plus en plus simples à utiliser en masquant la complexité technique sous-jacente], et bien d’autres encore [7]. Quoi qu’il en soit, cet article ne se concentre pas sur les avantages et les inconvénients de l’adoption de l’IA. Il se concentre strictement sur la comptabilité énergétique et des émissions, afin de donner au grand public et aux chercheurs une meilleure idée de l’ampleur et de la portée de la diffusion de l’IA, ainsi que des pressions qu’elle exerce sur les ressources de la planète. Les auteurs de cet article estiment tous deux que la spéculation financière autour du secteur de l’IA est devenue une bulle et que, comme toutes les bulles précédentes, celle-ci prendra fin, entraînant une chute vertigineuse du volume des investissements mondiaux. Cependant, la date à laquelle cela pourrait se produire et l’impact que cela pourrait avoir sur la présente évaluation dépassent également le cadre de cet article.
***
En 2026, notre analyse révèle que la diffusion et le déploiement de l’IA sont responsables de pas moins de 1,1% de la demande énergétique mondiale totale, un chiffre nettement supérieur à ce que suggèrent la plupart des estimations conventionnelles simplistes. Par exemple, une analyse simpliste de Our World in Data affirme que la diffusion de l’IA ne représente que 0,2% de la demande mondiale en énergie primaire [8]. Comme nous l’expliquons en détail dans cet article, ce type d’évaluations est généralement peu utile, car elles se concentrent uniquement sur la consommation d’électricité et ignorent la dynamique énergétique plus large tout au long du cycle de vie qui alimente la diffusion de l’IA à l’échelle mondiale. En réalité, nous montrons que la consommation énergétique mondiale liée à l’IA est probablement déjà supérieure à celle de l’ensemble du Royaume-Uni. Nous estimons également que l’IA sera responsable d’environ 1,2% de l’ensemble des émissions mondiales de GES pour cette année. Ce sont là des chiffres stupéfiants qui contredisent les discours habituels sur l’insignifiance relative de l’IA dans la consommation énergétique mondiale.
Nous ne prétendons pas que les résultats présentés ici constituent des réponses définitives aux questions que nous avons posées. En effet, nous tenons à reconnaître ouvertement, dès le départ, que notre méthodologie et nos calculs, présentés en détail ci-dessous, comportent diverses lacunes, omissions et hypothèses simplificatrices, dont la quasi-totalité est nécessaire compte tenu de la portée de cette analyse et des contraintes liées aux données. Ces points seront abordés en détail, ce qui, nous l’espérons, épargnera à nos détracteurs bien des efforts inutiles. Les résultats de cette analyse doivent être considérés comme une approximation de premier ordre et comme un point de départ vers des recherches et des investigations plus approfondies, afin que des évaluations détaillées de deuxième et troisième ordres puissent aboutir à des réponses plus précises à l’avenir.
La quantité de travail qui reste à accomplir dans ce domaine est considérable. Nos principaux objectifs pour cet article sont les suivants.
- Nous souhaitons susciter un changement dans la manière dont le grand public, les chercheurs universitaires, les grandes entreprises et les gouvernements abordent l’IA et son impact sur la consommation d’énergie, les émissions de GES et la biosphère planétaire. Cela implique avant tout d’expliquer en quoi les discours actuels sont cruellement insuffisants, puis de proposer de meilleures alternatives pour appréhender les enjeux auxquels nous sommes confrontés.
- Nous espérons encourager la poursuite des recherches dans ce domaine afin que d’autres groupes puissent aboutir à de meilleures réponses que celles que nous présentons ici.
- Nous espérons que cet article pourra servir de cadre de référence pour de futures actions politiques visant à affirmer un contrôle public et démocratique accru sur la portée, l’ampleur et la vitesse de l’onde de choc liée à la diffusion de l’IA qui secoue actuellement une grande partie du monde.
IA et énergie: une introduction
Le terme «intelligence artificielle» suscite de nombreuses opinions et interprétations. Le premier point de départ de cette analyse consiste à déterminer ce que nous entendons par IA. Dans ce contexte, nous définissons l’IA comme tout système génératif, agentique, logiciel ou robotique reposant partiellement ou entièrement sur la logique symbolique classique (comme les frameworks robotiques TAMP où les planificateurs de logique symbolique s’associent à la vision par ordinateur, à la reconnaissance de motifs géométriques, etc.), l’apprentissage profond avec des réseaux neuronaux, ou une combinaison des deux.
Sont exclus de cette définition les modèles, systèmes et processus reposant sur des techniques telles que la régression logistique, les forêts aléatoires ou le gradient boosting [combiner progressivement des modèles faibles]. Sont inclus dans cette définition les grands modèles linguistiques (LLM) comme ChatGPT, Claude, Copilot et Gemini, mais aussi les agents d’IA, les véhicules autonomes, les robots industriels, les robots autonomes, les logiciels d’aide à la décision en entreprise, comme les systèmes d’aide à la décision clinique dans les hôpitaux, et bien d’autres encore. En termes simples: si vous reposez de quelque manière que ce soit sur la logique symbolique ou les réseaux neuronaux, vous êtes classé dans la catégorie de l’IA pour les besoins de cette analyse. Les débats philosophiques sur ce qui constitue l’intelligence et sur la question de savoir si les LLM ou les agents IA sont réellement des êtres conscients ou intellectuels dépassent le cadre de cette analyse.
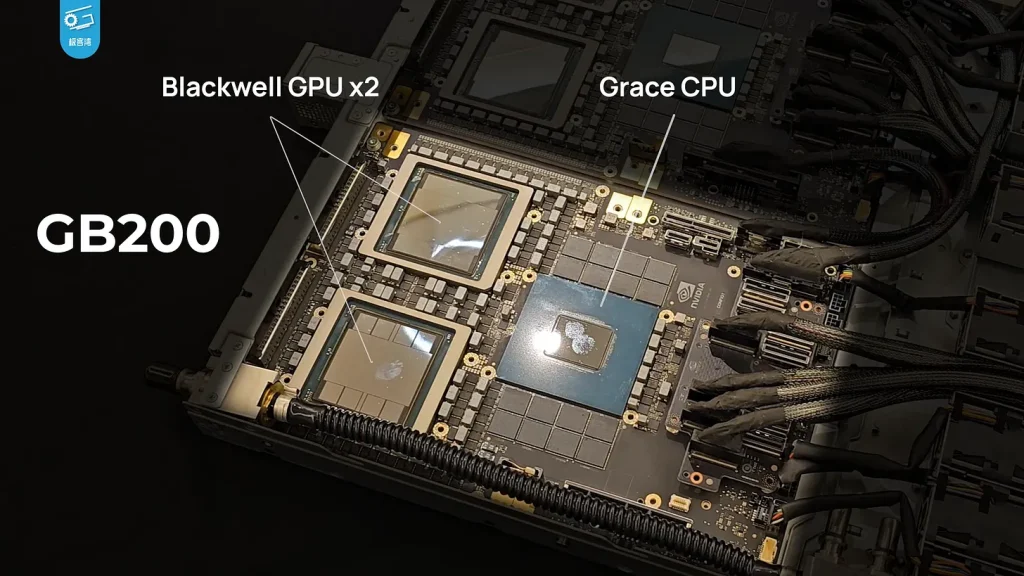
La plupart des utilisateurs interagissent avec des systèmes d’IA sans prêter attention aux conditions sous-jacentes nécessaires à leur création. Or, avant qu’un modèle ou un système d’IA puisse être déployé, il doit être entraîné et développé. Cela nécessite le stockage de vastes quantités de données dans le cloud. Cela implique le déploiement d’équipements spécialisés tels que des processeurs graphiques (GPU), des accélérateurs, des puces mémoire, des baies de serveurs, des commutateurs réseau, des émetteurs-récepteurs optiques, des câbles à fibre optique, des refroidisseurs, des tours de refroidissement, et bien d’autres éléments encore. Pour répondre aux exigences du calcul IA haute performance, des milliers de GPU sont reliés entre eux afin de fonctionner comme un supercalculateur de facto, souvent assistés par des puces de mémoire à haute bande passante (HBM) empilées verticalement juste à côté des GPU. Les GPU reçoivent des données d’entrée et des instructions provenant du monde extérieur, puis les utilisent pour effectuer des calculs rapides, sous la forme de multiplications matricielles qui mettent en œuvre les architectures de réseaux neuronaux au cœur des systèmes d’IA modernes (voir illustration 2). Tous ces éléments doivent être fabriqués, transportés, installés, réparés et maintenus en fonctionnement continu afin de garantir qu’ils puissent soutenir correctement la diffusion et le déploiement de l’IA. Et une fois que les modèles d’IA sont entraînés et déployés, les utilisateurs envoient des requêtes et des invites en tant qu’entrées et reçoivent divers résultats, allant du texte écrit et des diagrammes aux images et vidéos.
Emma Strubell [Carnegie Mellon University, Language Technologies Institute] et ses collaborateurs ont publié en 2019 un article majeur qui a attiré l’attention du monde entier sur les modèles d’IA très gourmands en énergie alors en cours de développement [9]. Par exemple, l’article concluait que l’entraînement d’un modèle d’IA de première génération à l’aide d’une méthodologie de recherche d’architecture neuronale émettrait l’équivalent de 600 000 livres [quelque 271 000 kg] de dioxyde de carbone, soit à peu près ce que rejettent 30 000 voitures aux États-Unis en une seule journée dans des conditions de conduite normales.
Bien que cet article ait été révolutionnaire, il a marqué le début d’une tendance regrettable consistant à analyser la demande énergétique de l’IA principalement à travers le prisme de la consommation d’électricité opérationnelle, une tendance qui a persisté dans de nombreuses études récentes, d’où proviennent des faits anecdotiques tels que «l’entraînement du GPT-4 d’OpenAI [de Sam Altman] a coûté plus de 100 millions de dollars et consommé 50 gigawattheures d’énergie, soit suffisamment pour alimenter San Francisco pendant trois jours» [10]. Cette tendance à analyser les besoins et la capacité opérationnels a conduit la plupart des publications universitaires sur le sujet à ignorer largement les dynamiques du cycle de vie, telles que les processus en amont et en aval affectés par le déploiement de l’IA. Tout le monde sait désormais qu’une requête typique sur ChatGPT peut consommer jusqu’à dix fois plus d’électricité qu’une recherche Google classique [11]. Mais la consommation d’électricité n’est qu’un aspect de cette histoire, et ce n’est même pas le plus important.
Udit Gupta [Cornell Tech, spécialisé dans la jonction de l’architecture informatique, des systèmes, de l’apprentissage automatique et de la durabilité environnementale] et ses collaborateurs ont remis en question cette focalisation sur la consommation opérationnelle dans un article novateur publié en 2021, qui a démontré que les émissions intrinsèques dépassent largement les émissions opérationnelles des systèmes informatiques modernes [12]. Plusieurs études ont examiné les liens entre les modèles d’IA, l’énergie et les émissions tout au long du cycle de vie. Dans un article publié en 2022, Sasha Luccioni [actuellement titulaire de la chaire Justice sociale et IA de l’Ecole normale supérieure] et son équipe ont estimé les émissions totales sur l’ensemble du cycle de vie liées à l’entraînement du modèle d’IA BLOOM [13]. Confirmant les résultats de Gupta et d’autres chercheurs, ils ont montré que le carbone intrinsèque du matériel informatique dépassait largement les émissions liées à l’exploitation résultant de l’entraînement du modèle lui-même.
Dans un célèbre article publié en 2023, Alex de Vries [Université d’Amsterdam] a montré que les besoins en inférence de l’IA dépasseraient bientôt de loin la consommation d’électricité utilisée pour l’entraînement [14]. L’article a modélisé plusieurs scénarios futurs de consommation d’électricité, le scénario le plus pessimiste à court terme prévoyant que la consommation d’électricité de Google atteigne le même niveau que celle de l’Irlande. Cependant, l’analyse s’est uniquement concentrée sur la consommation d’électricité et a ignoré les effets de réseau ainsi que la dynamique du cycle de vie du déploiement de l’IA. D’autres chercheurs ont montré que les systèmes d’IA peuvent présenter des empreintes carbone radicalement différentes selon le lieu, le moment et la manière dont ils sont exécutés, en particulier lorsqu’ils ne disposent pas d’une capacité de stockage par batterie suffisante et sont soumis aux variations liées à l’énergie éolienne et solaire [15]. Par exemple, certaines charges de travail liées à l’IA pourraient être transférées vers des centres de données alimentés par des énergies renouvelables, ce qui réduirait ainsi leurs émissions.
***
Les centres de données et autres infrastructures d’IA reposent fondamentalement sur des minéraux et matières premières critiques extraits de la Terre. Le cuivre est utilisé pour le câblage, le lithium pour les batteries, et les éléments de terres rares entrent dans la composition des aimants industriels utilisés pour les ventilateurs de refroidissement et les disques durs. Tous ces minéraux et éléments essentiels proviennent de diverses chaînes d’approvisionnement mondiales, complexes et extractives [16]. Les opérations minières nécessaires à l’obtention de ces matières premières ont une empreinte carbone importante, car elles finissent par détruire les puits de carbone et les paysages locaux, sans parler des émissions liées à l’exploitation de gigantesques véhicules et machines fonctionnant au diesel, comme les foreuses rotatives à explosifs. Le traitement d’une seule tonne de métaux de terres rares produit environ 2000 tonnes de déchets toxiques [17]. À Baotou, en Chine [Mongolie-Intérieure], un immense lac de boues toxiques s’est formé au fil des ans à la suite du traitement des terres rares, ruinant la qualité de l’eau locale et dévastant les communautés locales.
L’industrie des semi-conducteurs est le cœur battant du développement des centres de données. Les semi-conducteurs sont fabriqués dans des usines de fabrication, ou «fabs». De nombreuses entreprises considérées comme des fabricants de semi-conducteurs ne produisent en réalité pas leurs propres puces ou composants. Elles sous-traitent plutôt la production à des fabricants tiers. Le fabricant de semi-conducteurs le plus important au monde est Taiwan Semiconductor Manufacturing Company (TSMC). TSMC fonctionne selon un modèle économique de fonderie, ce qui signifie qu’elle ne conçoit rien ; elle se contente de fabriquer les dispositifs et composants physiques. D’autres entreprises, comme NVIDIA [Jen-Hsun Huang] ou AMD [processeurs GPU, PDG Lisa Su], sont des sociétés de logiciels qui se chargent de la conception, puis transmettent leurs plans à TSMC afin que celle-ci puisse produire les puces correspondantes. Au sens strict, TSMC est un fabricant de puces, tandis qu’une entreprise comme NVIDIA est un concepteur de puces.
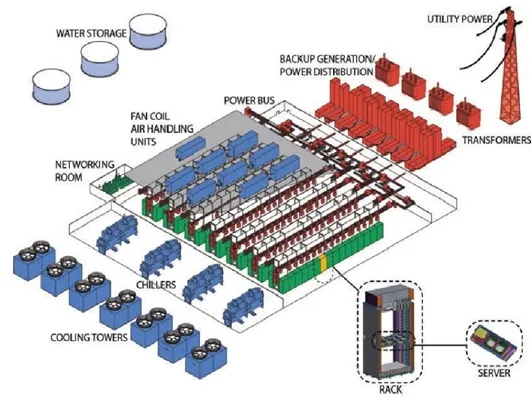
Et ces entreprises ne représentent qu’une infime partie de l’industrie des semi-conducteurs. Les micropuces sont fabriquées selon un processus très complexe comprenant des étapes telles que la gravure, la photolithographie, le dépôt, les tests et l’assemblage, qui nécessitent toutes certaines des machines et des équipements de fabrication les plus avancés que l’humanité ait jamais conçus. La société néerlandaise ASML fabrique les machines de lithographie les plus avancées au monde, qui utilisent des capteurs et des lasers de pointe pour graver des motifs complexes sur des plaquettes de silicium. Applied Materials produit certains des systèmes de dépôt les plus avancés au monde. Ces puces d’IA s’appuient en outre sur un écosystème physique composé de baies de serveurs, de commutateurs réseau, d’émetteurs-récepteurs optiques, de systèmes de refroidissement et de câbles à fibre optique (voir illustration 3). Les baies de serveurs elles-mêmes nécessitent de grandes quantités d’acier et d’aluminium, deux métaux issus d’industries à forte intensité énergétique qui émettent d’énormes quantités de dioxyde de carbone.
En 2023, les centres de données états-uniens représentaient environ 4,4% de la consommation nationale d’électricité, soit 180 TWh, ce qui équivaut à peu près à la consommation totale de la Thaïlande et à environ quatre fois celle de la ville de New York [18]. En 2000, ils ne représentaient que 0,1% de la consommation totale d’électricité; leur part dans la consommation nationale a donc augmenté de 4000% en moins de 25 ans [19]. Dans d’autres pays, la part des centres de données dans la consommation nationale d’électricité est encore plus élevée; ils représentaient plus de 10% de la production totale d’électricité de l’Irlande en 2021, et devraient aujourd’hui avoisiner les 20% de la consommation totale d’électricité du pays [20].
Prenons un instant pour expliquer notre approche des unités dans cette analyse. L’unité que nous utilisons le plus souvent est le térawattheure (TWh), une unité d’énergie. À titre de comparaison, 1 TWh d’énergie permet d’alimenter environ 100 000 foyers états-uniens moyens pendant un an. Nous ferons également référence à d’autres unités en fonction de celles utilisées dans les sources originales que nous citons, telles que les mégajoules (MJ) ou les exajoules (EJ), qui sont toutes deux des unités d’énergie. Nous utiliserons également des unités telles que le gigawatt (GW), une unité de puissance. La puissance correspond simplement à l’énergie par unité de temps. À titre de comparaison, 1 GW de capacité de puissance peut couvrir la consommation d’environ 750 000 foyers états-uniens, bien que ce chiffre puisse atteindre près d’un million dans certaines circonstances [21]. Étant donné que nous utilisons tant de types d’unités différents, nous effectuerons de nombreuses conversions entre ces unités. L’objectif de cette analyse est de limiter au maximum les calculs et les équations; nous ne présenterons donc pas toutes les étapes de conversion nécessaires.
L’efficacité des centres de données s’est considérablement améliorée au fil du temps. L’indice d’efficacité énergétique (PUE) correspond à la consommation totale d’énergie d’un centre de données divisée par l’énergie consommée par son matériel informatique. Par définition, ce chiffre sera toujours supérieur à 1, et plus il est proche de 1, plus le centre de données est considéré comme efficace. Il y a environ 15 ans, le PUE des centres de données s’élevait en moyenne à environ 2 [22]. Aujourd’hui, les principaux sites hyperscale [système à grande échelle, pour héberger et exploiter plusieurs milliers de serveurs, capable de s’adapter rapidement à des demandes importantes de ressources] atteignent souvent des valeurs comprises entre 1,1 et 1,2, tandis que les moyennes globales du parc se situent plutôt entre 1,4 et 1,6, ce qui représente un gain majeur en termes d’efficacité moyenne [23]. Cette amélioration de l’efficacité s’inscrit dans une tendance plus large du secteur informatique, illustrée par la loi de Koomey, qui observe que le nombre de calculs par joule d’énergie dissipée double environ tous les deux ans.
Malgré cette incroyable hausse d’efficacité, la consommation électrique totale des centres de données a explosé, comme nous l’avons expliqué plus haut. C’est un exemple canonique du paradoxe de Jevons à l’œuvre. Tirant son nom de l’économiste britannique William Stanley Jevons, qui avait observé au XIXe siècle que la consommation globale de charbon continuait d’augmenter en Grande-Bretagne alors même que les machines à vapeur gagnaient en efficacité, ce paradoxe stipule que plus les systèmes industriels et technologiques deviennent efficaces sous le capitalisme, plus ils consomment d’énergie, car les coûts de production diminuent, les produits deviennent moins chers ou plus rentables, et la demande augmente en conséquence. Les preuves empiriques à l’appui sont accablantes [24].
Au-delà des seuls centres de données, on peut en trouver de nombreux exemples dans l’histoire moderne. La production d’acier a explosé après que le procédé Bessemer a rendu la fabrication de l’acier plus efficace [25]. La production d’engrais a grimpé en flèche après que le procédé Haber-Bosch a rendu la production d’ammoniac nettement plus efficace [26]. La consommation d’eau dans l’agriculture mondiale a atteint des sommets à la fin du XXe siècle avec l’introduction de méthodes d’irrigation plus efficaces [27]. La liste est encore longue. Comme expliqué dans The Physics of Capitalism et dans cet article, le changement technologique sous le capitalisme est souvent orienté vers l’augmentation de l’exergie, c’est-à-dire le travail utile maximal pouvant être extrait d’un système lorsqu’il atteint l’équilibre avec son environnement. En d’autres termes, les capitalistes cherchent systématiquement à étendre l’échelle du système énergétique en construisant des dispositifs plus gourmands en énergie, puis ils exploitent les gains d’efficacité qui en résultent pour stimuler davantage la production et la consommation, car l’ensemble du système est structurellement orienté vers la croissance biophysique.
***
Ce phénomène est également facile à observer au niveau des appareils. Une puce d’IA Hopper typique de NVIDIA consomme environ 700 W [28]. La puce Blackwell de nouvelle génération est bien plus efficace, dans la mesure où elle peut effectuer davantage de calculs par unité d’énergie consommée, mais elle fonctionne également à environ 1200 W [29]. Les puces plus récentes, comme Rubin, seront encore plus efficaces, mais cela conduira probablement à une adoption et une diffusion accrues, et donc à une consommation d’énergie plus importante. Les puces d’IA gagnent peut-être en efficacité, mais elles deviennent également plus gourmandes en énergie au niveau unitaire [30]. C’est ce qui s’est également produit avec les machines à vapeur pendant la Révolution industrielle. Les premières machines à vapeur pouvaient générer bien moins d’énergie mécanique que les versions ultérieures; ainsi, non seulement elles sont devenues plus efficaces, mais elles sont également devenues plus grandes, plus complexes et plus gourmandes en énergie.
Les systèmes complexes peuvent s’étendre en taille parce qu’ils gagnent en efficacité, mais il arrive aussi que des chocs exogènes affectant leur échelle énergétique forcent ou incitent les composants du système à devenir plus efficaces. Ce sont là certaines des dynamiques qui sous-tendent le développement des infrastructures d’IA à l’échelle mondiale: la recherche de l’amélioration va de pair avec une tendance à l’agrandissement, notamment des puces plus grandes, des robots plus imposants, des centres de données hyperscale, etc. Cette frénésie infrastructurelle est également en partie alimentée par ce qu’on appelle les «lois d’évolutivité de l’IA», qui ont convaincu une grande partie du monde technologique que le fait d’injecter davantage de données et de ressources de calcul dans les réseaux neuronaux améliorera considérablement leurs performances au fil du temps [31]. L’une des grandes inconnues concernant l’avenir du développement des infrastructures d’IA réside dans la direction que prendra le secteur technologique si ces lois d’évolutivité commencent à se heurter à des obstacles et à des limites insurmontables. L’eau est l’une des ressources biophysiques les plus limitées pour le secteur de l’IA, mais c’est aussi l’un des sujets les plus mal compris dans le contexte plus large de la question énergétique liée à l’IA; nous devons donc acquérir une compréhension claire de la manière dont elle s’intègre au reste du système. (Article publié sur le site d’Erald Kolasi le 27 juillet 2026, deuxième partie à suivre le 8 novembre. Traduction rédaction A l’Encontre)
Erald Kolasi est physicien et économiste. Auteur de nombreux articles sur «les dynamiques écologiques». Jesse Damiani a couvert entre autres pour le magazine Forbes les technologies émergentes.
Notes
1. Christian Bogmans et al., “Power Hungry: How AI Will Drive Energy Demand,” International Monetary Fund, April 22, 2025. https://www.elibrary.imf.org/view/journals/001/2025/081/article-A001-en.xml.
2. Article, “How Hyperscalers are Fueling the Race for 24/7 Clean Power,” McKinsey & Company, December 18, 2024. https://www.mckinsey.com/industries/electric-power-and-natural-gas/our-insights/how-hyperscalers-are-fueling-the-race-for-24-7-clean-power.
3. ASML, “Busting ASML myths,” 2022. https://www.asml.com/en/news/stories/2022/busting-asml-myths.
4. Sean M. Davis, “Implications of Taiwan’s dependence on imported energy,” Lehigh University, October 29, 2025. https://preserve.lehigh.edu/system/files/derivatives/coverpage/460057.pdf.
5. Arjen Y. Hoekstra, “The hidden water resource use behind meat and dairy,” Animal Frontiers, vol. 2, April 2012, pp. 3-8. https://academic.oup.com/af/article/2/2/3/4638610?login=false.
6. Miriam Aczel, et al., “Environmental Cost of AI’s Energy Use,” Institute for Water, Environment, and Health, United Nations, 2026. https://collections.unu.edu/eserv/UNU:10647/UNU-INWEH-Report-The_Env_Cost_of_AI-2026.pdf.
7. For a thorough discussion on these issues, see Google DeepMind, “From AGI to ASI,” June 12, 2026. https://deepmind.google/research/publications/239142/.
8. Hannah Ritchie, “How much energy do data centers and artificial intelligence use?”, Our World in Data, July 20, 2026. https://ourworldindata.org/how-much-energy-do-data-centers-and-artificial-intelligence-use.
9. Emma Strubell, Ananya Ganesh, and Andrew McCallum, “Energy and Policy Considerations for Deep Learning in NLP,” Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, Florence, Italy, Association for Computational Linguistics, pp. 3645–3650. https://aclanthology.org/P19-1355/.
10. For a major example, see James O’Donnell and Casey Crownhart, “We did the math on AI’s energy footprint.” MIT Technology Review. May 20, 2025. https://www.technologyreview.com/2025/05/20/1116327/ai-energy-usage-climate-footprint-big-tech/
11. Josie Stewart, Brooke Tanner, and Nicol Turner Lee, “As energy demands for AI increase, so should company transparency,” Brookings Institution, July 14, 2025. https://www.brookings.edu/articles/as-energy-demands-for-ai-increase-so-should-company-transparency/.
12. Udit Gupta et al., “Chasing Carbon: The Elusive Environmental Footprint of Computing,” 2021 IEEE International Symposium on High-Performance Computer Architecture, February 2021. https://ieeexplore.ieee.org/abstract/document/9407142.
13. Sasha Luccioni, Sylvain Viguier, and Anne-Laure Ligozat, “Estimating the Carbon Footprint of BLOOM, a 176B Parameter Language Model,” Journal of Machine Learning Research, 2023. https://www.jmlr.org/papers/v24/23-0069.html.
14. Alex de Vries, “The growing energy footprint of artificial intelligence,” Joule, vol. 7, October 18, 2023. https://www.cell.com/joule/fulltext/S2542-4351(23)00365-3.
15. Jesse Dodge et al., “Measuring the Carbon Intensity of AI in Cloud Instances,” Proceedings of the ACM Conference, on Fairness, Accountability, and Transparency, 1877-1894, June 20, 2022. https://dl.acm.org/doi/pdf/10.1145/3531146.3533234.
16. See Kate Crawford, Atlas of AI: Power, Politics, and the Planetary Costs of Artificial Intelligence (New Haven: Yale University Press, 2022).
17. Jonathan Kaiman, “Rare earth mining in China: the bleak social and environmental costs,” The Guardian, March 20, 2014. https://www.theguardian.com/sustainable-business/rare-earth-mining-china-social-environmental-costs.
18. Miguel Yañez-Barnuevo, “Data Center Energy Needs Could Upend Power Grids and Threaten the Climate,” Environmental and Energy Study Institute, April 15, 2025. https://www.eesi.org/articles/view/data-center-energy-needs-are-upending-power-grids-and-threatening-the-climate?hl=en-US.
19. Allan Chen, “Data center energy use: truth versus myth,” Berkeley Lab, July 16, 2002. https://www2.lbl.gov/Science-Articles/Archive/data-center-energy-myth.html?hl=en-US.
20. Peter L. Borland, Kevin McDonnell, and Mary Harty, “Assessment of the Potential to Use the Expelled Heat Energy from a Typical Data Centre in Ireland for Alternative Farming Methods,” Energies, vol. 16, 2023. https://www.mdpi.com/1996-1073/16/18/6704.
21. Huwan Peng et al., “Chiplet Cloud: Building AI Supercomputers for Serving Large Generative Language Models,” arXiv, 2023. https://arxiv.org/pdf/2307.02666.
22. Rich Miller, “Uptime Institute: The Average PUE is 1.8,” Data Center Knowledge, May 10, 2011. https://www.datacenterknowledge.com/uptime/uptime-institute-the-average-pue-is-1-8?hl=en-US.
23. Google. “Growing the Internet while reducing energy consumption,” Data Centers. https://datacenters.google/efficiency/?hl=en-US.
24. See John M Polimeni, Kozo Mayumi, Mario Giampietro, and Blake Alcott, The Myth of Resource Efficiency: The Jevons Paradox (New York: Taylor & Francis Group, 2009) pp. 141-172. Also see Richard York and Alexander McGee, “Understanding the Jevons Paradox,” Environmental Sociology, 2015. https://www.researchgate.net/profile/Julius-Mcgee/publication/285643149_Understanding_the_Jevons_paradox/links/5bdb72704585150b2b982762/Understanding-the-Jevons-paradox.pdf?_sg%5B0%5D=started_experiment_milestone&origin=journalDetail.
25. Robert B. Gordon. American Iron, 1607-1900 (Baltimore: John Hopkins University Press, 2001).
36. Vaclav Smil, Enriching the Earth: Fritz Haber, Carl Bosch, and the Transformation of World Food Production (Cambridge: MIT Press, 2001).
27. R Quentin Grafton et al., “The paradox of irrigation efficiency,” Science, vol. 361, 748-750, 2018. https://www.science.org/doi/abs/10.1126/science.aat9314.
28. Daiyaan Arfeen et al., “Nonuniform-Tensor-Parallelism: Mitigating GPU failure impact for Scaled-Up LLM Training,” arXiv, April 8, 2025. https://arxiv.org/abs/2504.06095.
29. Ibid.
30. For further details, see Carly Davenport et al., “AI, data centers, and the coming US power demand surge,” Goldman Sachs, April 28, 2024. https://www.goldmansachs.com/pdfs/insights/pages/generational-growth-ai-data-centers-and-the-coming-us-power-surge/report.pdf.
31. Jared Kaplan et al., “Scaling Laws for Neural Language Models,” arXiv, 2020. https://arxiv.org/pdf/2001.08361/1000.
Soyez le premier à commenter